Nagy nyelvi modell (LLM): jelentés és gyakorlati példa
A nagy nyelvi modell, röviden LLM, nagy mennyiségű adaton tanított gépi tanulási modell, amely nyelvi mintázatok alapján képes szöveget feldolgozni és előállítani. A szöveget tokeneknek nevezett egységekkel kezeli. Önmagában nem azonos egy keresővel, egy naprakész adatbázissal vagy egy teljes AI-asszisztenssel.
Más elnevezések: LLM · large language model · nyelvi modell
Röviden
- Az LLM technológiai összetevő; az alkalmazás további eszközöket és keresést kapcsolhat hozzá.
- A folyékony szöveg nem bizonyítja az állítások igazságát.
- A tanítás során elsajátított mintázatok és az aktuális feladathoz kapott források különböznek.
Ezen az oldalon
Mi a modell szerepe?
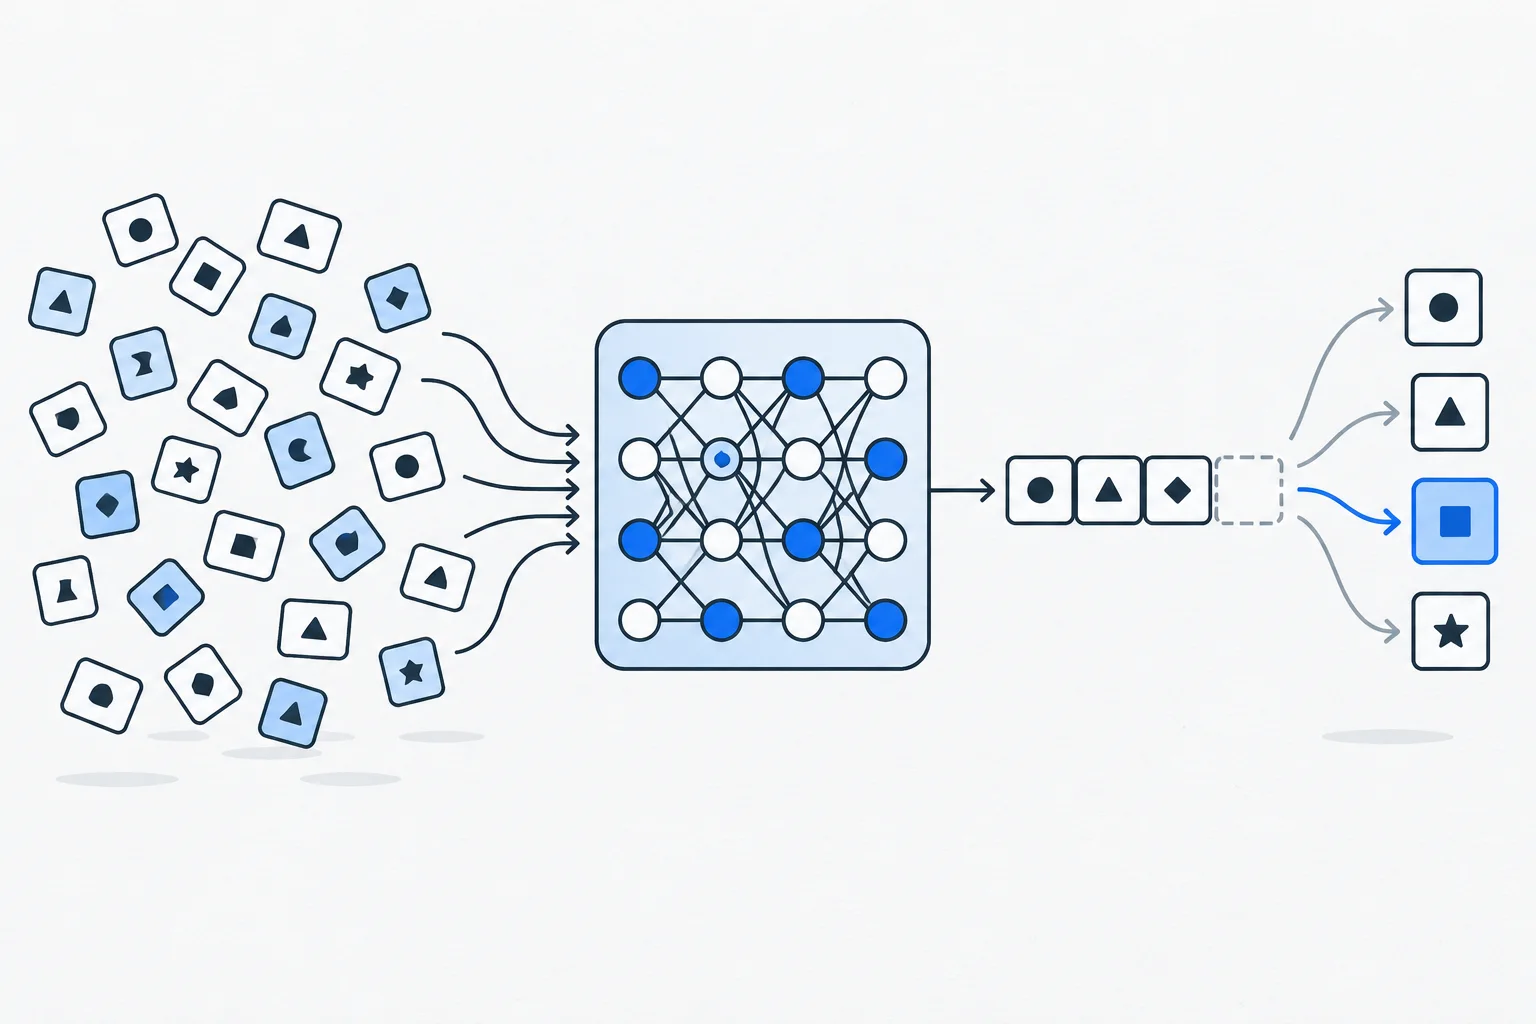
A nyelvi modell a bemenet és a tanítás során kialakult mintázatok alapján állít elő kimenetet. A szöveg előállításakor kisebb egységekkel, tokenekkel dolgozik. Egy token nem feltétlenül teljes szó: lehet szórész vagy más szövegegység is, a használt feldolgozástól függően.
A Google gépi tanulási tananyaga részletesen bemutatja a nyelvi modellek alapelvét. A fogalom megértéséhez nem szükséges minden matematikai részletet ismerni. Az üzleti szempontból lényeges különbség az, hogy a jól megformált válasz létrehozása és a válasz ténybeli ellenőrzése nem ugyanaz a művelet.
Miben más egy teljes AI-alkalmazás?
Egy AI-asszisztens a modell mellett keresőeszközt, dokumentumtárat, jogosultságkezelést és felhasználói felületet is használhat. Amikor a termék friss webes adatot keres, nem feltétlenül a modell tanításában tárolt ismeretet idézi fel: külön információs forrást ér el, majd azt használhatja a válaszhoz.
Az AI-keresés ezért tágabb folyamat, mint az LLM szövegalkotása. A RAG például visszakeresett dokumentumokkal egészítheti ki a generálást. Egy szolgáltatás képességéről így nem elég annyit tudni, hogy milyen modellnevet említ; azt is látni kell, milyen adatokhoz és eszközökhöz fér hozzá a konkrét feladatban.
A modell tudáshatára a tanítási információ időbeli lefedettségére vonatkozik, nem az alkalmazás által visszakereshető összes forrás közzétételi dátumára. Egy keresőeszköz a modell újratanítása nélkül is adhat frissebb bizonyítékot. Fordítva, egy közeli tudáshatár sem garantál teljes és pontos ismeretet minden korábbi eseményről; a válaszhoz ténylegesen felhasznált bizonyítékot kell ellenőrizni.
Mit ad hozzá a prompt és a kontextus?
A prompt mondja meg a feladatot, és háttéranyagot is tartalmazhat. A kontextusablak az egyszerre figyelembe vehető információ korlátjához kapcsolódik. Egy feltöltött leírás vagy korábbi beszélgetés az aktuális válasz bemenetének része lehet, de ettől nem válik automatikusan a modell tartósan megtanult tudásává.
Ez fontos különbség egy vállalkozás saját dokumentumainál. Ha egy asszisztenshez megadsz egy új árlistát, a válasz az adott környezetben használhatja azt. Ebből nem következik, hogy minden más felhasználó vagy minden későbbi beszélgetés ugyanazt az árlistát ismeri. A termék adatkezelése és működése külön vizsgálatot igényel.
Példa: egy szolgáltatási leírás összefoglalása
Egy képzeletbeli költöztetőcég három jóváhagyott dokumentumából szeretne rövid bemutatást. A modell feladata lehet az ismétlődő mondatok összevonása és a szolgáltatások érthető rendezése. A tulajdonos azonban nem szeretné, hogy a rendszer nem létező csomagolási vagy raktározási szolgáltatást adjon hozzá.
A használható eredményhez egyértelmű feladat, megfelelő forrás és szerkesztői ellenőrzés kell. A modell gördülékeny mondata önmagában nem igazolja, hogy a felsorolt szolgáltatást a cég tényleg vállalja. Ez szemléltető helyzet, nem egy termék valós teljesítménymérése vagy ajánlás egy adott modell mellett.
A példa azt is megmutatja, hogy a nyelvi feladat és az üzleti igazság forrása különbözik: a megfogalmazást segítheti a modell, az érvényes vállalást a cég dokumentációja adja.
Miért keletkezhet téves válasz?
Az AI-hallucináció során a rendszer meggyőzőnek tűnő, de hibás vagy nem alátámasztott részletet állíthat. Ez lehet név, szám, hivatkozás vagy egy forrás túl tág értelmezése. A hiba nyelvileg akár teljesen természetes szövegben is megjelenhet.
Az ellenőrzés ezért ne csak a helyesírásra és a hangnemre terjedjen ki. Kérdezd meg minden fontos állításnál, honnan származik, és a forrás valóban azt mondja-e. Különösen lényeges a frissülő termékadat, az ár, a határidő és a vállalási feltétel, mert ezek tévedése közvetlenül félrevezetheti az olvasót.
Hogyan értékeld a használhatóságát?
Konkrét feladattal és ellenőrizhető elvárással tesztelj. Egy összefoglalónál számít a forráshűség, egy magyarázatnál a közérthetőség, egy összehasonlításnál a megfelelő szempontok és a hiányzó adatok jelzése. A hosszabb vagy magabiztosabb válasz nem automatikusan jobb.
A modell a munkafolyamat egyik része. Használhatóságát az adatok minősége, a feladat megfogalmazása, az eszközök és az ellenőrzés együtt alakítja. Ezért egy látványos bemutató helyett a saját valós feladatodon, ismert forrásokon és következetes értékeléssel érdemes megítélni az eredményt.