Kontextusablak: jelentés és gyakorlati példa
A kontextusablak a modell által egy feldolgozás során figyelembe vehető információ mennyiségének korlátja, amelyet jellemzően tokenekben adnak meg. Ide kerülhet az utasítás, a beszélgetés elérhető előzménye és a feladathoz átadott anyag. Nem azonos a modell tanítás során elsajátított ismereteivel vagy egy termék tartós memóriájával.
Más elnevezések: context window · kontextushossz
Röviden
- A token nem ugyanaz, mint egy szó vagy karakter.
- A nagyobb keret több anyagnak adhat helyet, de nem garantál helyes feldolgozást.
- A beszélgetési előzmény, a tartós memória és a visszakeresett forrás különböző fogalom.
Ezen az oldalon
Mi férhet a kontextusba?
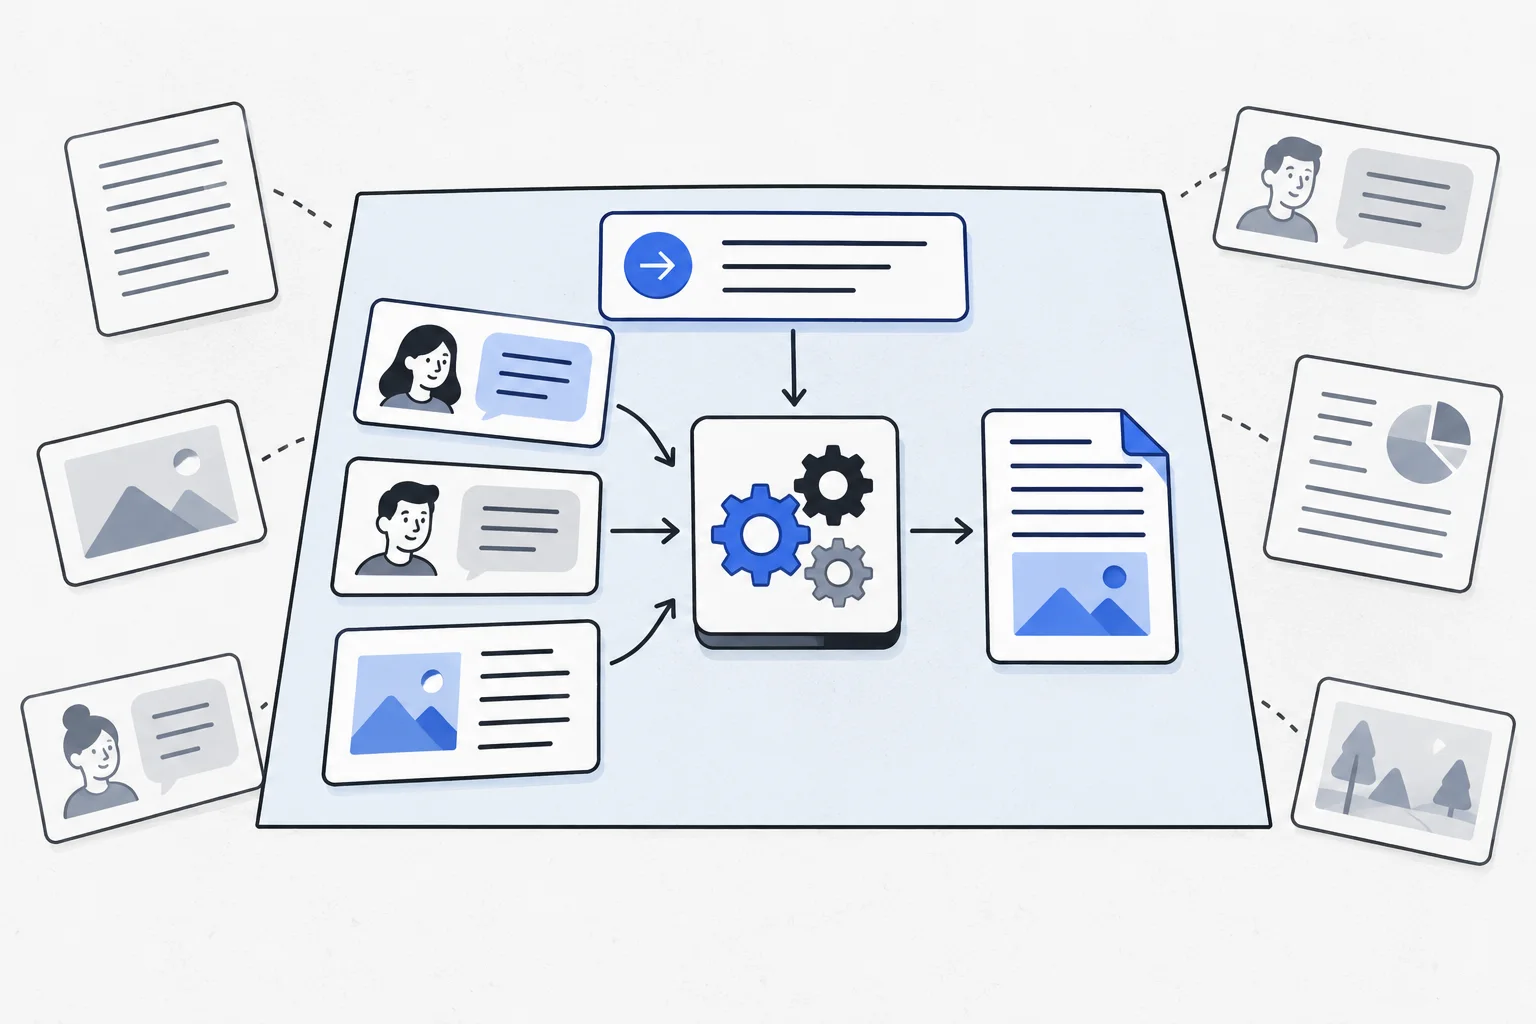
A modell egy feladat során utasításokat, korábbi üzeneteket és feldolgozandó anyagokat is kaphat. Ezek együtt alkotják az aktuálisan rendelkezésre álló környezetet. A kontextusablak azt korlátozza, mennyi ilyen információ kezelhető egy adott feldolgozásban; a pontos számolás és a kimenet helyigénye modellfüggő.
A Google hosszú kontextusról szóló útmutatója ezt a korlátot és a nagyobb bemenetek használatát tárgyalja. Nem érdemes minden AI-termékre egyetlen univerzális oldalszámot megadni. A szöveg nyelve, formátuma és egyéb tartalma is befolyásolja, hogyan fér el a keretben.
Mi az a token?
A nagy nyelvi modell a szöveget tokeneknek nevezett egységekkel dolgozza fel. Egy token lehet szó, szórész vagy más egység. Ezért a „száz oldal” vagy „tízezer szó” nem ugyanaz a mérték, mint a tokenek száma.
Egy rövid magyar kifejezés és egy azonos hosszúságúnak látszó angol kifejezés is eltérően darabolódhat. A tartalomhoz kapcsolt képek vagy más bemeneti formák kezelése szintén termékfüggő. Ha a feladat mérete fontos, az adott rendszer tényleges korlátját és számlálását nézd, ne egy általános internetes átváltási arányt tekints pontos mérésnek.
Az AI-token a számlálás egysége, a kontextusablak pedig a kapacitás korlátja. Hosszú feladat előkészítésekor a tényleges bemenetet az adott tokenizálóval számold meg, és a modell szabályai szerint hagyj helyet a kimenetnek is. A feltöltési fájlméretkorlátba beleférő dokumentum még meghaladhatja a használható kontextust, mert a fájlméret és a tokenkapacitás különböző dolgokat mér.
Miben más, mint a memória vagy a tanítás?
A kontextus az adott feldolgozáshoz elérhető információ. A modell tanítása ettől külön folyamat, a termék tartós memóriája pedig külön funkció lehet. Attól, hogy egy dokumentumot egyszer megadtál, nem következik, hogy minden későbbi beszélgetésben teljes egészében rendelkezésre áll.
A beszélgetéses keresésnél az előzmények kezelése alkalmazásonként eltérhet. Egy hosszú párbeszédet a termék összefoglalhat vagy részleteiben adhat tovább. A felhasználó ezért ne feltételezze automatikusan, hogy a beszélgetés elején szereplő minden feltétel változatlanul jelen van a következő válaszban.
Példa: több verzió egy hosszú beszélgetésben
Egy képzeletbeli ügynökség egy szolgáltatási oldal szövegén dolgozik. Először régi árakat ad meg, később új csomagokat, majd több körben módosítja a célközönséget. Ha a feladatban nem világos, melyik változat érvényes, a sok elérhető információ inkább zavart okozhat, mint segítséget.
A következő promptban célszerű röviden összefoglalni az aktuális, jóváhagyott feltételeket, és elkülöníteni a már elvetett változatokat. A példa szemléltető munkafolyamat, nem egy adott rendszer belső memóriakezelésének leírása. A cél az érvényes források és a feladat egyértelművé tétele.
A végleges szöveget ezután is ellenőrizni kell. Az új összefoglaló maga is lehet hiányos, ha fontos feltétel maradt ki belőle.
Hogyan kapcsolódik a visszakereséshez?
A RAG megkeresheti a feladathoz releváns dokumentumrészleteket, majd ezek kerülhetnek a válasz bemenetébe. Így nem feltétlenül kell minden rendelkezésre álló dokumentumot egyszerre átadni. A jó kiválasztás azonban külön feladat, amely hibázhat vagy fontos részt hagyhat ki.
A forrásalapú megalapozás szempontjából az a fontos, hogy a válaszhoz szükséges bizonyíték ténylegesen rendelkezésre álljon, és helyesen legyen felhasználva. A nagy kontextusablak önmagában nem biztosítja sem a releváns anyag kiválasztását, sem a megfelelő értelmezést.
Mitől lesz használható a nagyobb keret?
Hosszú anyagnál segíts a szerkezettel: egyértelmű címek, verziók és elkülönített dokumentumok könnyítik a feldolgozást és az ellenőrzést. A feladatban nevezd meg, milyen kérdésre keresel választ, és mely anyag tekinthető irányadónak. A több bemenet akkor értékes, ha a lényeges részleteket szolgálja.
Az eredményt konkrét állításokon teszteld. Megtalálta a fontos kivételt, helyesen választotta ki az érvényes változatot, és nem keverte össze a szereplőket? Ezek a kérdések többet mondanak a feladat sikeréről, mint önmagában a kontextusablak mérete a termék adatlapján.