Szervernapló-elemzés: mit kértek le valójában a robotok?
A szervernapló-elemzés a webhely kiszolgálási rétegeiben rögzített kérések vizsgálata. Megmutathatja, mely URL-eket, mikor és milyen eredménnyel kértek le, de a napló helye és lefedettsége meghatározza, mi látható benne. Egy robotnak látszó kérés azonosságát külön ellenőrizni kell.
Más elnevezések: log file analysis · logelemzés · robotnapló-elemzés
Röviden
- A User-Agentben szereplő Googlebot név önmagában nem hiteles botazonosítás.
- A CDN-ből kiszolgált kérések hiányozhatnak az alkalmazásszerver naplójából.
- Egy sikeres lekérés nem bizonyít indexelést, rangsorolást vagy emberi látogatást.
Ezen az oldalon
Mi szerepelhet egy kérésnaplóban?
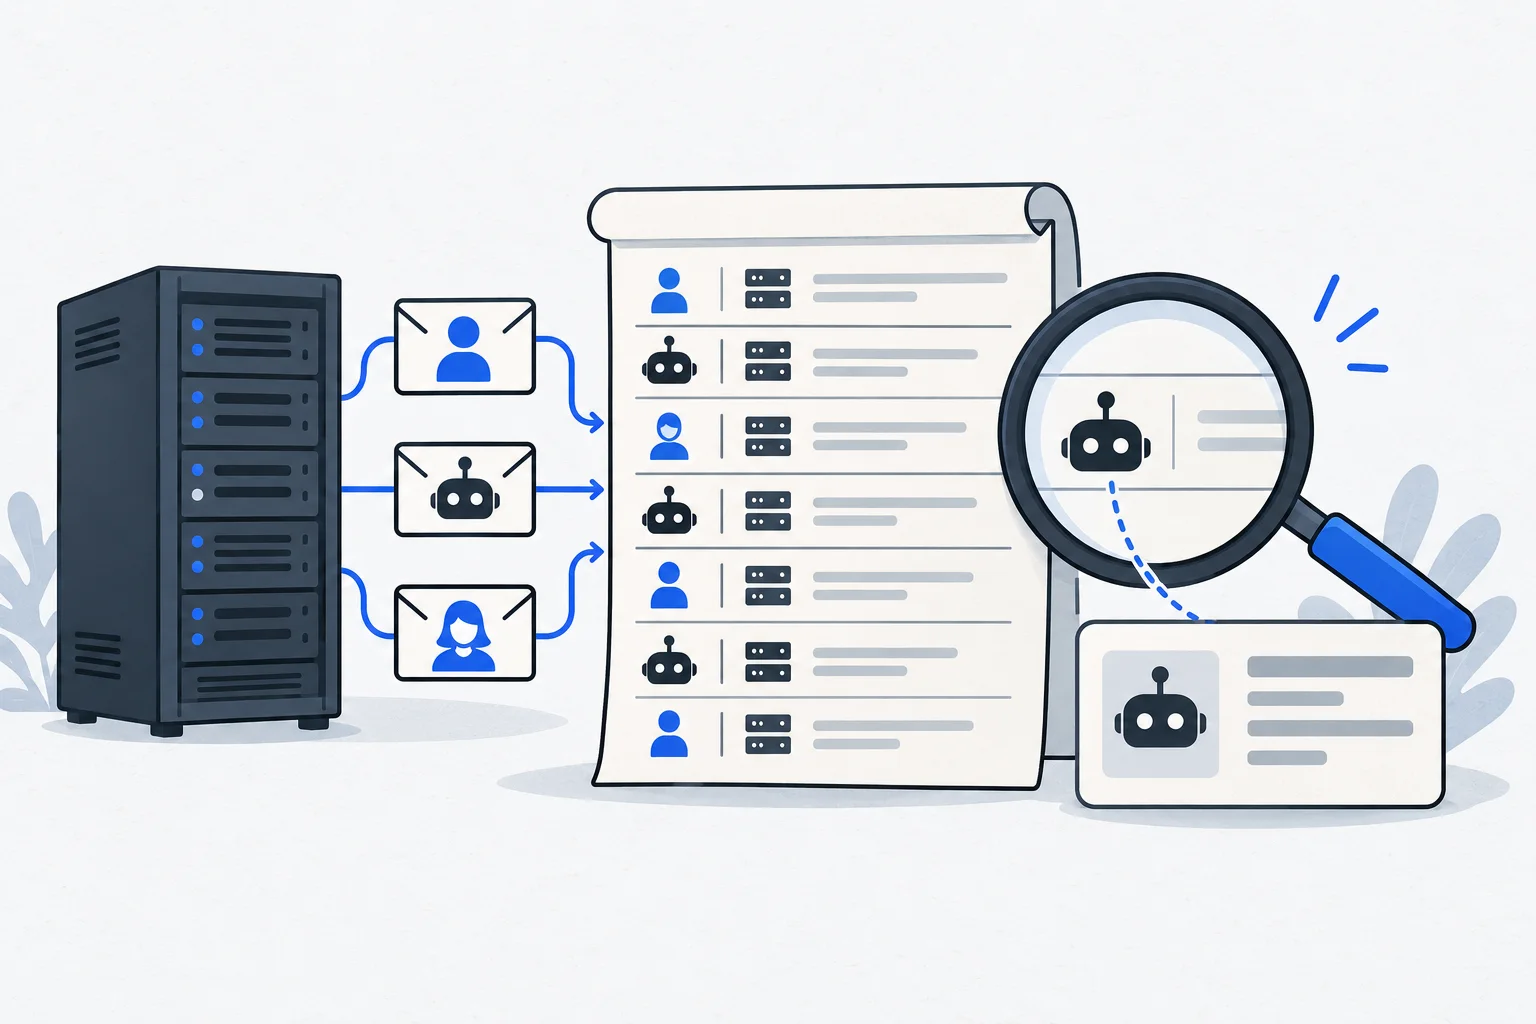
A napló jellemzően rögzítheti a kérés időpontját, útvonalát, módszerét, válaszkódját és a kiszolgálás további adatait. Ebből megvizsgálható például, hogy egy robot rendszeresen eléri-e a fontos oldalt, vagy ugyanazokba a hibás címekbe ütközik.
A pontos mezők a szolgáltatótól és a beállítástól függnek. Nem minden napló teljes, és nem minden kérés kerül ugyanabba a rendszerbe. Mielőtt következtetést vonnál le, tisztázni kell az időszakot, az időzónát, a mintavételezést és azt, melyik kiszolgálási réteg készítette a feljegyzést.
Miben más, mint a webanalitika?
A böngészőben futó mérőkód felhasználói eseményeket és látogatásokat figyelhet. A szervernapló ezzel szemben a kiszolgálási kérésekről szól. A robotok jelentős része nem úgy hajtja végre a webanalitikát, mint egy ember böngészője, ezért a két rendszer számai nem várhatók azonosnak.
Az organikus forgalom emberi érkezéseket jelölő analitikai nézete nem Googlebot-kérésszám. Egy kép vagy stíluslap lekérése sem új látogató. Ugyanakkor a napló olyan hibát is megmutathat, amely miatt a böngészős mérőkód már el sem jut a futásig.
Hogyan ellenőrizhető a Googlebot azonossága?
A User-Agent fejlécet a kérés küldője adja meg, ezért önmagában hamisítható. A Google hivatalos útmutatója több ellenőrzési módszert ismertet, például közzétett IP-tartományok vagy megfelelő vissza- és előreirányú DNS-ellenőrzés használatát.
Az ellenőrzésben a ténylegesen megbízható forrásból származó klienscím számít. Egy tetszőlegesen beküldhető továbbítási fejlécből kiolvasott cím nem feltétlenül alkalmas erre. Ha CDN vagy proxy van a webhely előtt, annak dokumentált naplózási és továbbítási működését kell érteni, nem egy fejléc nevét automatikusan hitelesnek tekinteni.
Példa: a robot „eltűnt” az origin naplójából
Egy képzeletbeli tudástárnál új gyorsítótárat kapcsolnak be. Az alkalmazásszerveren kevesebb Googlebotnak tulajdonított kérés látszik, miközben a nyilvános oldalak továbbra is jól elérhetők. A csapat első feltételezése az, hogy a kereső ritkábban látogatja a webhelyet.
A CDN naplója azonban azt mutatja, hogy a robot kéréseinek egy részét már az élkiszolgáló válaszolja meg. Az origin csökkenése ebben a példában a kiszolgálási út változásából következik. Ettől még a hiteles botazonosságot és a válaszokat ellenőrizni kell. Az alkalmazásnapló önmagában nem látta a teljes forgalmat.
Milyen mintákat érdemes keresni?
A feltérképezés szempontjából hasznos lehet az URL-családok, a válaszkódok és a válaszidők összevetése. Sűrűn lekért hibás paraméteres címek, ismétlődő átirányítások vagy nagy arányú szerverhibák konkrét vizsgálati pontot adhatnak.
A feltérképezési keret emlegetése előtt érdemes megkérdezni: valóban nagy webhelyről és fontos oldalak kimaradásáról van szó? Néhány fölösleges kérés nem automatikusan súlyos probléma. A lényeg, hogy a felfedezett mintázatnak legyen hatása a megfelelő tartalom elérésére vagy a működési költségre.
Mit nem bizonyít, és hogyan használd biztonságosan?
A sikeres 200-as lekérés azt igazolja, hogy azon a rétegen ilyen választ rögzítettek. Nem bizonyítja, hogy a Google indexelte az oldalt vagy megmutatta egy keresésben. A Search Console és a naplók ezért kiegészítő bizonyítékok, nem egymás helyettesítői.
A naplókban érzékeny adatok is lehetnek, különösen paraméterekben és azonosítókban. Az elemzéshez szükséges mezőkre korlátozott hozzáférés, megfelelő megőrzés és megosztás előtti szűrés fontos működési döntés. Egy külső hibajegyhez általában nem kell teljes, felhasználói adatokat tartalmazó naplóállományt mellékelni; az érintett mintázat anonimizált példája is elegendő lehet.